最近我把 Pi Agent 认认真真过了一遍。从外层状态、内层循环、生命周期钩子一条一条拆开看,一个能长期干活、能被打断、能记得住来龙去脉的 Agent,本质上不是一段脚本,而是一套有状态与无状态分层、有明确生命周期约束的系统工程。
这篇不是教程,是我学习过程中的一份拆解。我把它的整体流程、四大拆分、四层生命周期都整理进来,也顺便补一些我自己这两年做 Agent 时踩过的坑。所有要点我都保留,只做展开,不改动原意。
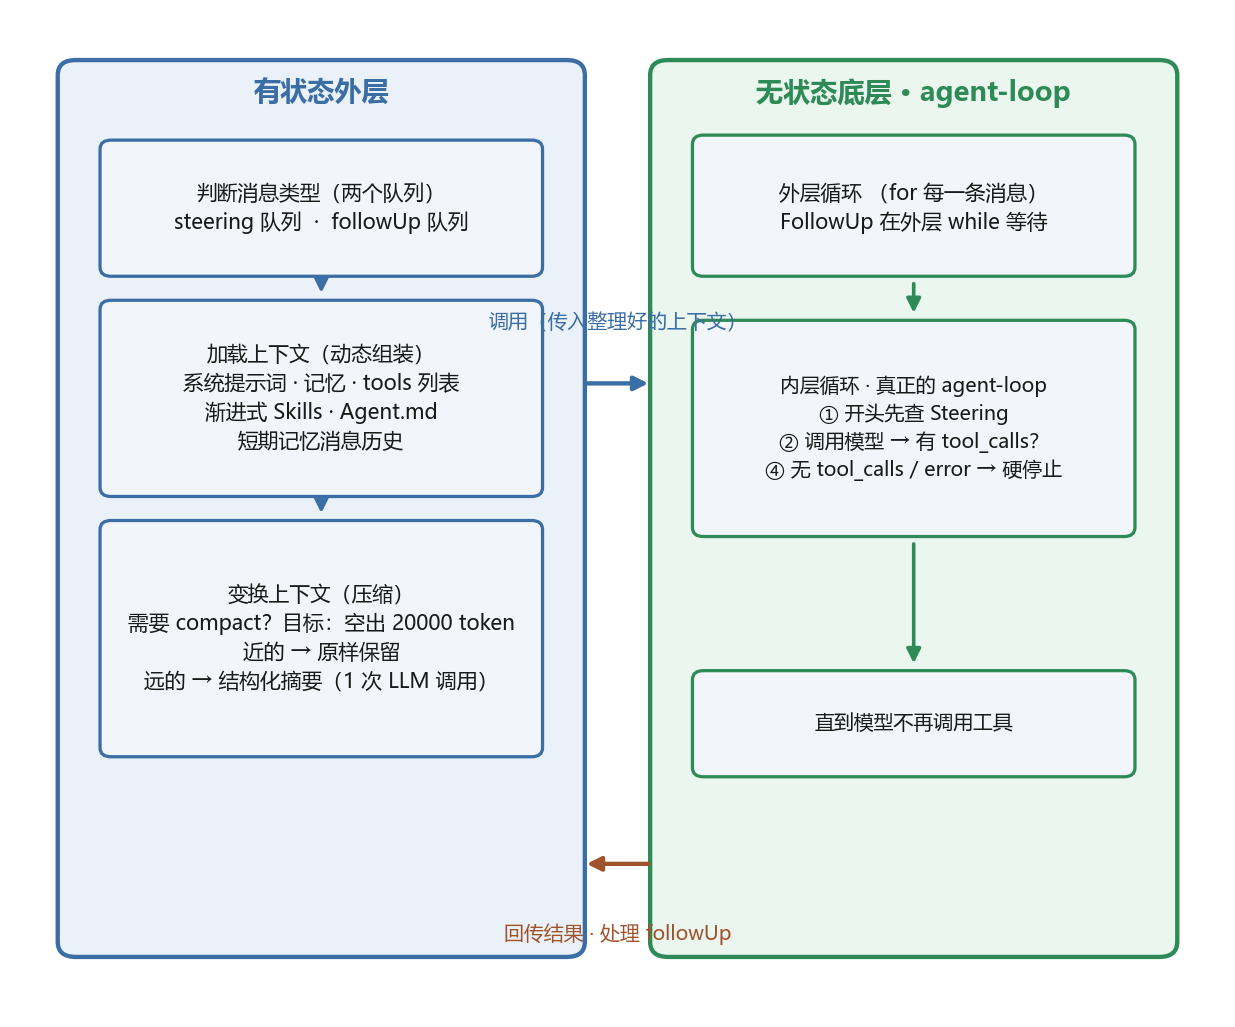
一句话看懂整体流程:有状态外层 + 无状态内层
Pi Agent 最核心的分层,就是"有状态的外层"和"无状态的内层"这两段代码。
有状态外层负责 Agent 的"记忆"和"调度"——它知道现在进行到哪了、用户想干什么、上下文要不要压缩、要不要换个分支。这些都需要持久化状态,所以它是有状态的。
无状态底层负责 每一条消息真正跑起来的 agent-loop——它每次进来都是"干净"的,不记住上一轮的事,只按传入的上下文执行。这很重要,因为只有当内层无状态时,你才能安全地重试、回滚、并行,而不用担心状态被污染。
外层把上下文准备妥当后,调用内层;内层跑完,把结果交还外层。这个“外层管状态、内层管执行”的分工,是理解整个架构的钥匙。
先分清两种输入:Steering 和 FollowUp
外层要处理的第一个判断,就是你这句消息到底是想"插嘴干预",还是"等结果"。
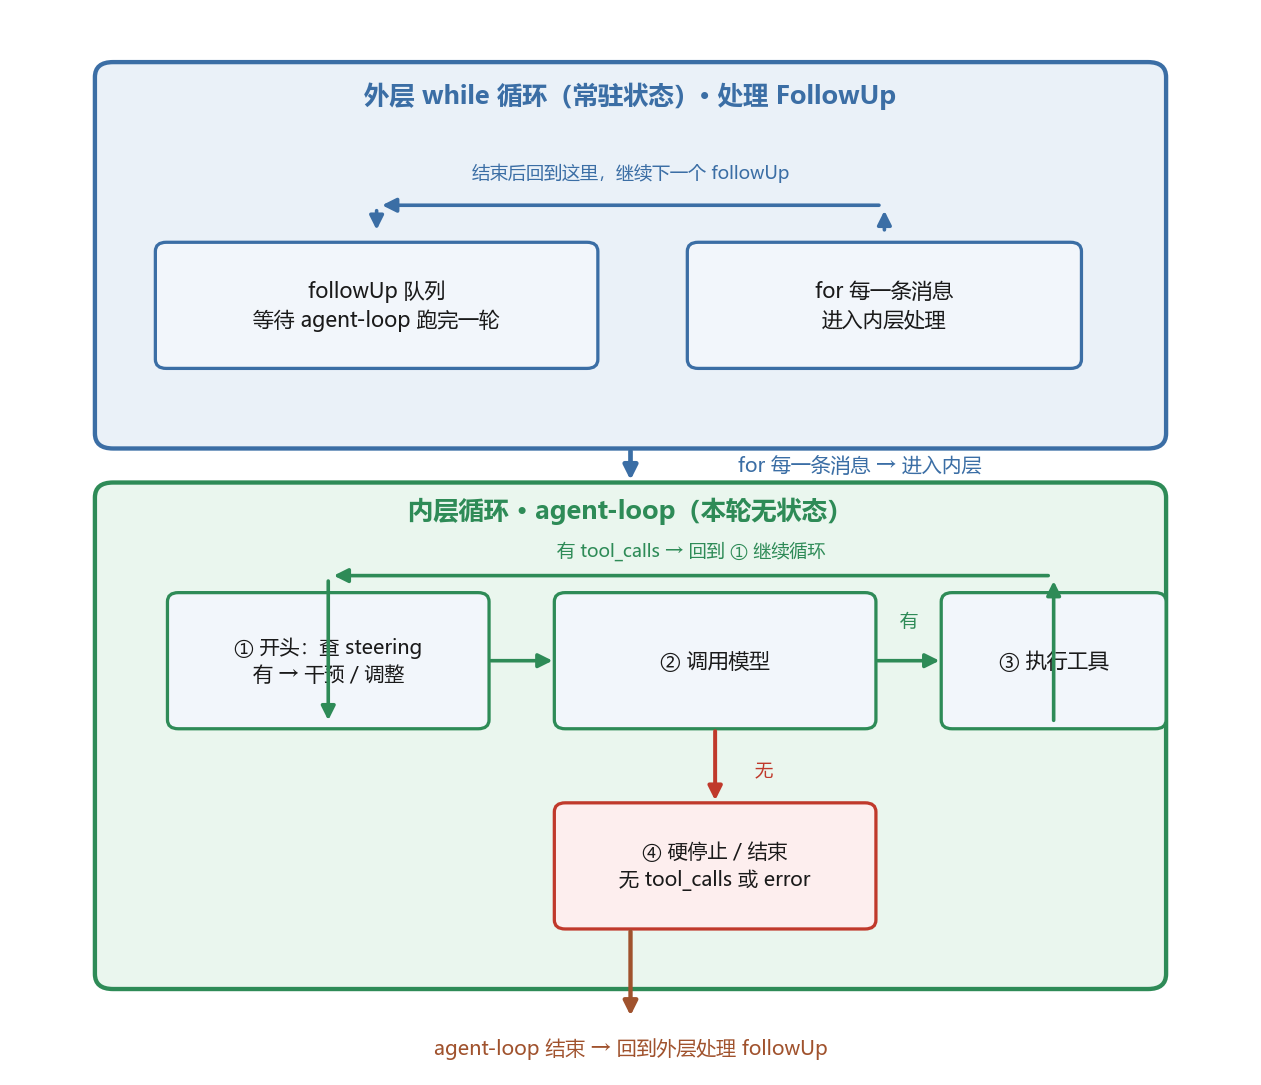
- Steering(引导):用户主动插进来的一句话,比如"别用 python 了,改用 node"、“先别读那个文件”。这种消息是要打断当前执行、改变 agent 正在做的事,所以它被放进一个专门的 steering 队列,在内层循环的开头被检查。
- FollowUp(追问):用户在当前任务结束之后的下一条消息,比如"好的那再帮我总结一下"。这种消息是在外层 while 循环里等着,等 agent-loop 跑完一轮之后再处理。
外层维护两个消息队列 steering 和 followUp。关键点在于:steering 是"实时干预",所以它在内层每轮循环开头就去抢答;followUp 是"排队后续",所以它在外层等 agent 真正停下来。
补充一句我自己的体会:很多 Agent 被诟病"失控",就是因为缺少 steering 这种通道——用户想打断,只能硬等它跑完,或者干脆杀进程。有专门的消息队列去接住用户的干预意图,体验是完全不一样的。
上下文加载:动态加载
在真正调用模型之前,外层会把这次运行的上下文拼装出来。它加载的东西有这么几类:
- 系统提示词:base prompt,模型行为的底层设定。
- 记忆:长期记忆,比如跨会话要记住的偏好和事实。
- tools 列表:这次会话暴露给模型的所有工具。
- 渐进式加载Skills:这是重点——Skills 不是一次全塞进去,而是用到才加载。
- Agent.md:专门写给 Agent 的任务说明书。
- 短期记忆的消息历史:当前会话窗口内最近的一串消息。
“渐进式加载 Skills"这点值得单独说。最开始我习惯把所有能力都一股脑塞进系统提示词,结果就是上下文越来越大、模型越来越"分心”。改成懒加载之后,Skills 只在真正匹配到任务时才被注入,既省 token,也让模型把注意力集中在当下真正需要的能力上。配合 Agent.md 这种面向 Agent 的说明文件,上下文就变成"按需组装",而不是"全部常驻"。
上下文变换:为下一轮清出 20000 token(这里写死了)
装完上下文还不够,紧接着要判断:上下文是不是太大了,需不需要压缩。
Pi Agent 的压缩策略很清晰:判断是否需要 compact,目标是空出 20000 token。具体做法是从最近的消息开始向上积累,一直累计到空出这 20000 token 为止。靠近现在的消息原样保留,因为它们是接下来最可能被用到的;而远离现在的早期消息,压缩成一段结构化摘要——而且只花一次 LLM 调用就搞定。
这个设计很聪明,它体现了两个取舍:
- 近的保真,远的浓缩。新近的上下文含金量最高,细节必须保留;老旧的对话大都是"为什么走到这一步"的背景,概括成摘要就够了。
- 一次调用一次性摘要。不是逐条滚动压缩,而是把"要丢的那一大段"一次性喂给模型,得到一份结构化的摘要顶替。既省调用次数,也避免反复压缩带来的信息累积失真。
我补充一点工程层面的背景:压缩永远是有损的,你摘掉的细节,模型在后面就再也看不到原话了。所以"近的保留、远的摘要"这个倾斜是合理的——它把损失集中在最不可能被重新用到的那部分,而不是平均地牺牲所有历史。
无状态 agent-loop:外层管消息,内层管工具
把上下文准备好之后,就进入无状态底层的 agent-loop。
外层循环负责处理用户的每一条消息——for 遍历每一个消息,每一条都进入内层处理。FollowUp 就是在外层 while 循环里等待着 agent-loop 跑完一轮的结果。
内层循环才是真正的 agent-loop。它的终止条件有两个:
- 没有 tool_calls 了——模型停下来,不再要求调用工具,说明这一轮的任务处理完了,可以正常结束。
- Erroe——发生了异常,走 硬停止,立即中断,任然可以继续调用工具。
在内层循环开头,会先看一眼有没有 Steering 消息。有,就调整当下正在做的事;没有,就继续按原计划跑。这正好呼应了前面说的 steering 队列——它是在这个"每轮循环开头"的位置被消费的。
这个内层循环“跑到 agent 不再调用工具为止”的设计,是整个 Agent 的发动机:只要模型还想调工具,就继续;一旦它给出最终文本回复、不再要工具了,循环就停。用户不会看到模型“思考到一半”的中间态,看到的是一轮完成的、确定的结果。
会话不是列表,是一棵树
这一块是我这次收获最大的部分。Pi Agent 的短期记忆,就是一个窗口内的所有 session,但它对"会话"的定义和我以为的很不一样:会话不是一排列表,对话是一棵树。
- 每条消息是一个节点。
- 回退、分支不删数据,只是移动指针。
这在工程上意味着:你想回到某个历史节点重新来一遍,或者从某个点分出一条新分支继续聊,历史数据一条都不会删,改的只是一个"当前指针"指向哪里。回退和分叉都是指针的移动,不是数据的销毁。
它用 jsonl 文件把整棵树持久化到用户目录下的 ~/.pi/agent/session 里,而且节点之间带父子级关系,这样能完整重建这棵对话树。
这个设计的价值很实在:
- 可回溯、可审计。你随时能看回之前的任何一条分支,因为数据都在。
- 安全的分叉探索。你想在同一个会话里尝试两种不同方案,不用复制粘贴上下文,直接开一条分支就行。
- 复盘成本低。跑错了一条分支,指针拉回来就好,不用重头再来。
而且——当用户进入一个新的会话分支时,会把旧的会话先摘要,再注入到新的上下文里。这样新的分支不是从零开始,而是带着"前面聊到哪了"的浓缩记忆继续走。让分支既"独立"又"有继承",这是它做得漂亮的地方。
上下文工程的四个关键动作
除了上面说的压缩,Pi Agent 的上下文工程还有几个配套动作,一起看更完整。
系统提示词的动态组装
系统提示词不是一份写死的文本,而是动态拼出来的:多层 CLAUDE.md 递归加载,再加上 Skills 懒加载,加载tool_list,会话记忆。CLAUDE.md 可以分层递归,一层层把约定叠进去;Skills 按需加载;Claude.md 补充任务级的指引。这几者合起来,构成这次运行真正生效的那份系统提示词。
工具输出的截断
这个点非常容易被忽略,但对 token 的消耗影响极大。像 read 文件、grep、bash 这类工具,一个输出就可能吃掉几千甚至几万 token。如果不设上限,一个不小心读了一个超大的日志文件,整个上下文就爆了。
所以工具输出要做截断:行数+字节限制双重限制 、截头+截尾两种策略:
比如读文件,截断留下前面的部分,bash命令,截断留下后面的内容,后续如果需要再继续读。这相当于给工具输出加了"渐进式披露"——模型每次只看到它请求的那一小段,想要更多,再显式地读下一段。既省了 token,也避免一次性塞太多噪声导致模型抓不住重点。
上下文的压缩
这个前面讲过:在 trace 之后,从最近消息向上积累,直到剩余 20000 token,近的保留、远的用一次 LLM 调用做结构化摘要。它发生在一次完整的执行(trace)结束之后,是一个"事后整理"的动作。
分支的摘要
这个也在会话树里讲过:用户进入新的会话分支,把旧的会话摘要之后注入新的上下文。它解决的是"分支之间怎么共享记忆"的问题。
这四招——组装、截断、压缩、分支摘要——合起来,就是一套完整的:用最少、最相关、最新鲜的 token,去支撑当前这一轮运行。上下文工程不是玄学,它就是"在有限的上下文窗口里,做最有价值的取舍"。
模型路由:一套规则,调用多种模型
Pi Agent 的模型调用也很有意思,它的做法是一种规则,调用多个模型。
不是每个任务都硬绑死一个模型,而是由一套路由规则去决定这次该用哪个模型。这样可以在"能力强的贵模型"和"便宜快的小模型"之间做选择:简单任务走便宜模型省成本,复杂推理走贵模型保质量。规则可以是基于任务类型、上下文长度、还是工具复杂度来决定——它是一套统一的调度逻辑,底层却可以对接多款模型。
工具执行:用 schema 和钩子兜底
Agent 的"手脚"就是工具,而工具执行这里,Pi Agent 用了两道保险:
- 钩子验证:在工具执行的 turn 前后 用钩子做验证,确认这次调用该不该发生、参数是不是合理。
- schema 验证:对工具调用做 schema 校验,确保参数的结构和类型的合法性,防止模型吐出一个格式对不上的调用。
还有一点:出错也算一条消息。工具执行失败,不会让整个 agent 崩溃,而是把报错作为一条普通消息喂回给模型,让它自己判断该怎么继续处理。这非常符合"Agent 要能自愈"的思路——错误不是终点,而是需要被模型理解的下一份上下文。
四层生命周期,10 个钩子节点:
pi agent围绕四层生命周期,10 个钩子节点搭建agent这就是pi agent的 harness
最后把整个架构的"骨骼"串起来。Pi Agent 定义了四层生命周期:
- trace:从会话开始到会话结束,是最外层的大生命周期。
- turn:一个 trace 里会发生多次模型调用,每一次模型调用 + 它这次调用所触发的工具执行,合起来算一个 turn。
在这四层(其实对应着 trace 和 turn 两级)的前后,以及更细的节点上,一共插了 10 个干预点:
- trace 开始前、trace 结束后;
- turn 开始前、turn 结束后;
- 模型调用的开始、运行、结束;
- 工具调用的执行开始、执行运行、执行结束。
这 10 个节点,就是 harness(运行时骨架) 用来干预、观察、验证、hook 的地方。你在每个节点上挂上钩子,就能做到:模型调用前做输入校验,工具执行后做结果审核,turn 结束做状态记录,trace 结束做上下文压缩——所有"横切"的能力,都挂在这个生命周期的节点上,而不用写死在 agent 的逻辑里。
这也是我最认同的一点:把"干预"做成生命周期上的钩子,而不是嵌在 agent 主流程里的 if-else。这样 agent 的核心逻辑保持干净、可测试,而安全、审计、压缩、观测这些关注点,都被优雅地分离到 harness 的节点上。这就是"把 Agent 当系统搭"的具象体现。
总结
把 Pi Agent 从头到尾拆完,我的核心感受是:它真正厉害的地方,不是某一个具体的 trick,而是一整套分层和生命周期的设计取舍。
- 有状态外层 / 无状态内层,让"记忆"和"执行"解耦,可回滚、可并行、可重试。
- 对话是一棵树而不是列表,让分支和回退变成指针移动,而不是数据摧毁。
- 上下文工程是一套"渐进式组装 + 截断 + 压缩 + 分支摘要"的组合拳,在有限的窗口里做最有价值的取舍。
- 生命周期上的 10 个钩子,把安全、观测、压缩这些横切逻辑,干净地塞进 harness,而不是写死进主流程。
它不是一句 prompt 加一堆工具,而是一套知道"现在在哪、要去哪、能怎么打断、该怎么收官"的系统。这四层骨架,就是让 Agent 从 demo 走向真正能长期干活的关键。如果你也在做自己的 Agent,我强烈建议先不要急着堆工具,而是先把这套"有状态外层 + 无状态内层 + 生命周期钩子"的骨架搭明白——它才是决定你的 Agent 能不能变得"可靠"的根本。
本文首发于 CSDN:拆开 Pi Agent:一个能把 Agent 当“系统“搭的架构,到底好在哪?