为什么要读 Mem0 的源码
用过大模型的人大概都有过这种体验:昨天刚跟它聊了半天,今天新开一个会话,它又不认识你了。它不是装的,是真的记不住。
Mem0 就是来治这个毛病的。它是目前最流行的开源记忆层之一,做的事情说起来很简单:把聊天内容提炼成事实存起来,下次用得上时再找回来。2026 年 4 月它发布了新的 v3 算法,整个写入和检索流程都重写了。
我花了些时间读它的源码,主要是 mem0/memory/main.py 和 mem0/utils/scoring.py。读完之后,我想在这篇文章里把三个问题讲清楚:
- 一条记忆到底存在哪里?
- 调用
add()和search()时,内部每一步在做什么? - 这套设计省掉了什么,又付出了什么代价?
为了不让你来回切换,全文只用一个例子:用户说"我下个月搬去上海,入职阿里做后端",几天后又问"我在阿里做什么岗位?"。
全景:一条记忆存成三份
先说一件我读源码之前没想到的事:你以为存的是一条记忆,其实它被写进了三个地方。每个地方只保存它的一个侧面,各自回答一类问题。
| 存储 | 存了什么 | 回答的问题 | 检索时是否参与 |
|---|---|---|---|
| 向量库(主记忆) | 记忆原文、embedding、哈希、词形还原文本、创建时间、过期日期等等。。。 | 哪条记忆和这个问题相关 | 是 |
| 实体库(向量库) | 抽取的文本实体,以及它出现在哪些记忆里(linked_memory_ids),由此关联到主记忆库 | 哪些记忆提到了这个东西 | 是,只负责加分 |
| SQLite | 每次变更的流水(ADD / UPDATE / DELETE)和近期原始对话 | 这条记忆是怎么来的 | 否 |
例子里的"用户将入职阿里做后端"这条事实,在向量库里是一条带 embedding 的记录,在实体库里是"阿里"指向它的一条索引,在 SQLite 里是一行 ADD 事件。
这里有两个地方,我一开始也理解错了:
- 向量库才是主存储。 SQLite 只是审计日志,固定使用 SQLite、不可配置,检索完全不碰它。
- 实体库不是知识图谱。 它只记"阿里出现在哪几条记忆里",不记"用户—入职—阿里"这种关系。真正的图记忆已经从开源版移除,只在 Platform 版提供(迁移指南)。
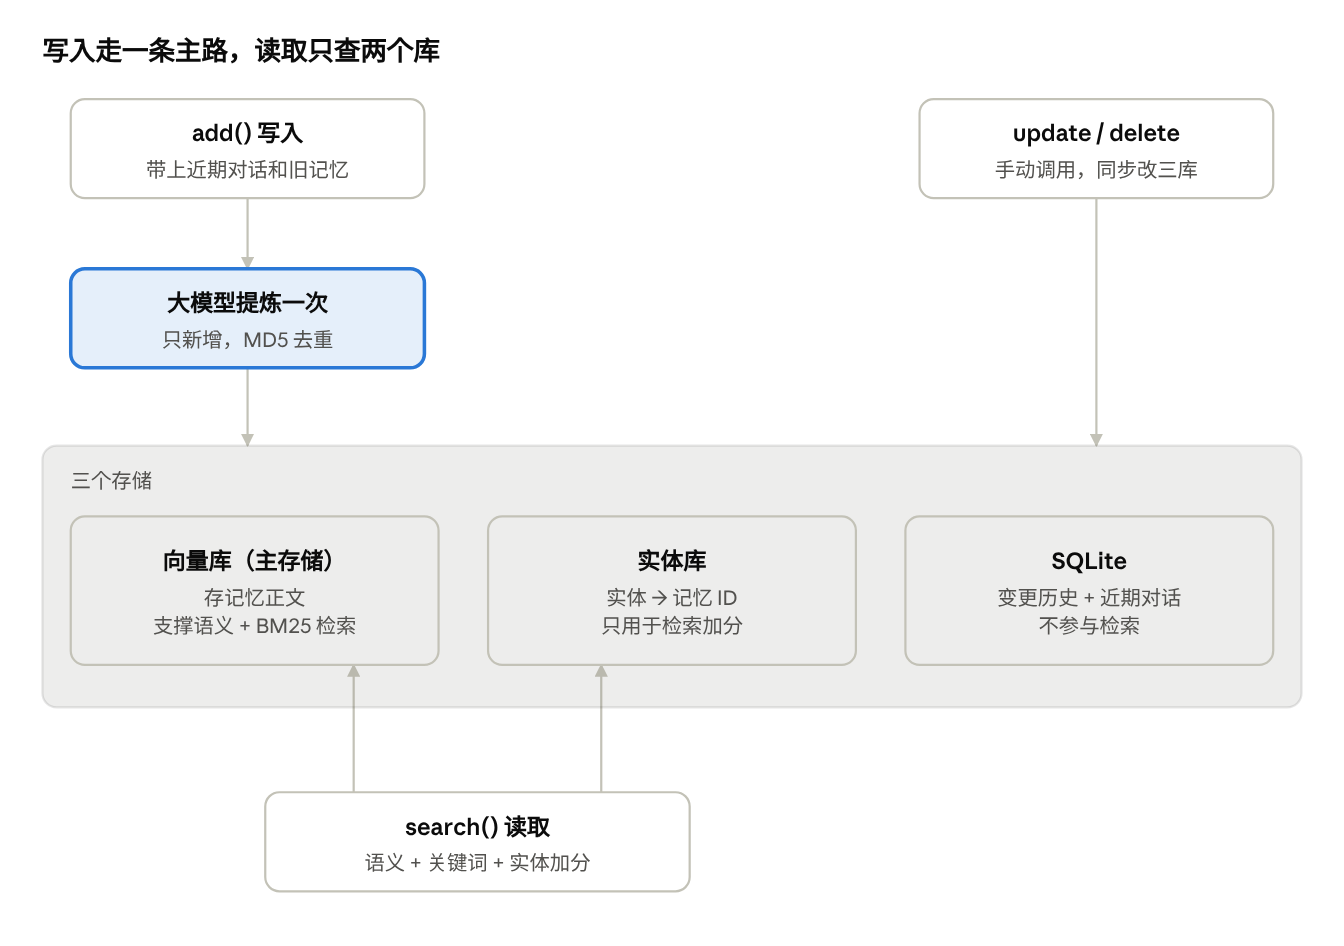
(图 1:架构总览图)
写入:add() 的九步
先说结论:整个写入流程只调用一次大模型,而且只做新增,从不修改或删除旧记忆。下面一步一步看。
假设库里已有一条旧记忆"用户住在北京",现在用户说:“我下个月搬去上海,入职阿里做后端。”
- 接收输入。 检查
user_id、agent_id、run_id至少给了一个,把这句话包成消息列表。 - 取近期对话。 从 SQLite 拿最近 10 条消息,让模型能看懂"它"“那家公司"这类指代。
- 找相似旧记忆。 对新消息做 embedding,在向量库里搜出最像的 10 条。这里命中"用户住在北京”。旧记忆的 ID 会被换成 “0” 到 “9” 的短编号,减少模型编造 ID。
- AI 提炼事实。 用
ADDITIVE_EXTRACTION_PROMPT调用一次大模型,返回两条事实:“用户下个月搬去上海"和"用户将入职阿里做后端”。“住在北京"原封不动。 - 转成向量。 两条事实批量算 embedding,批量失败就退回逐条处理。
- 去重。 每条事实算一个 MD5,和第 3 步那 10 条旧记忆的哈希比对,一字不差的丢掉。
- 写入记忆。 两条事实批量插入向量库,SQLite 的 history 表记两行 ADD。
- 链接实体。 抽出"上海"和"阿里”,到实体库里查有没有同一个实体:文本完全一致,或语义相似度达到 0.95,都算命中。命中就把新记忆 ID 并进去,没命中就新建。
- 保存原始对话。 原话存进 SQLite,下次第 2 步会用到。
跑完之后,库里有三条记忆:北京、上海、阿里。注意,“住在北京"那条还好好地躺在那儿。
每次 add() 的成本很固定:1 次大模型调用、1 次向量搜索、事实和实体各 1 次批量 embedding。
还有一条旁路:传 infer=False 时,原话直接 embedding 入库,不调用大模型、不去重、不做实体链接。它适合你已经自己整理好事实的场景。
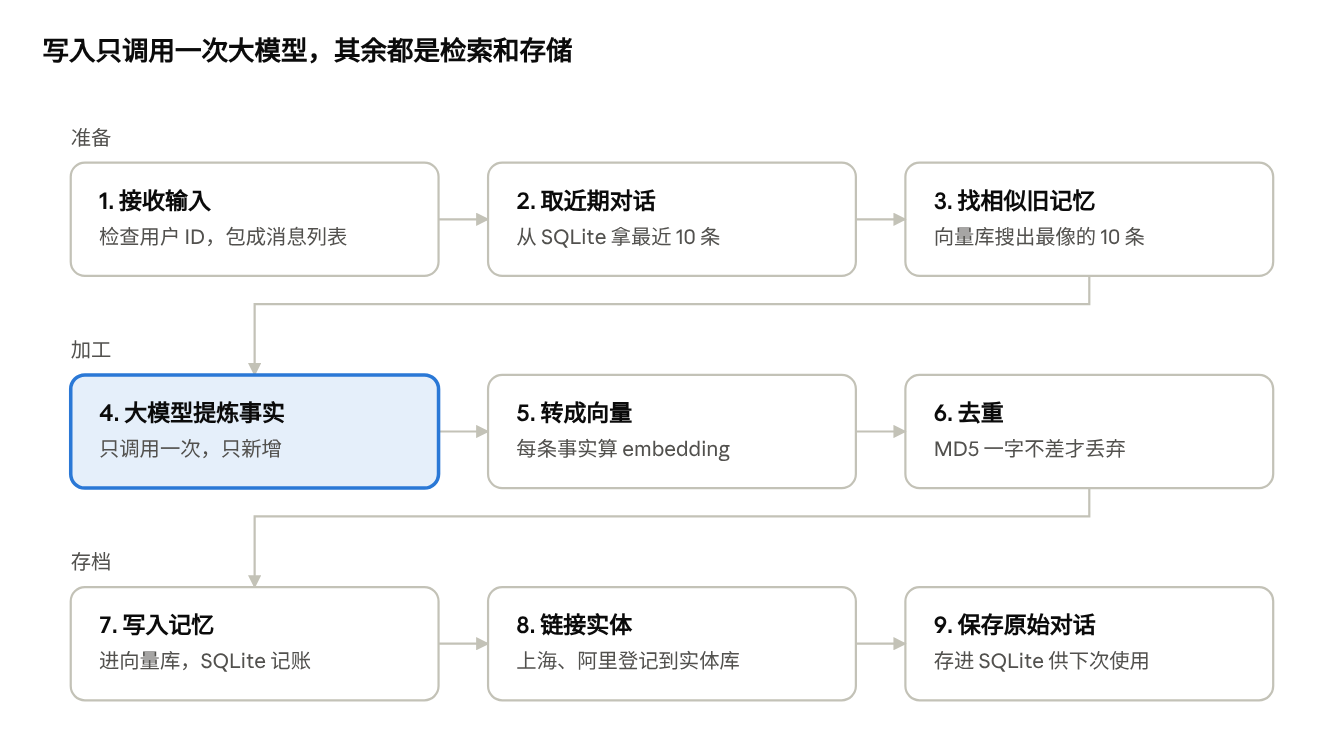
(图 2:添加记忆流程图)
读取:search() 其实是"语义海选,两路加分”
官方的说法是语义、关键词、实体三路信号融合,听起来像三路人马各自去找。但我翻了源码才发现不是这么回事:候选只来自语义搜索,另外两路只给入围的记忆加分。
几天后用户问:“我在阿里做什么岗位?”
- 接收问题。 检查参数,filters 里必须带用户 ID。默认
top_k=20、threshold=0.1、rerank=False。 - 处理问题。 做词形还原(给关键词搜索用),抽出实体"阿里",再算 embedding。
- 语义搜索。 从向量库取最像的
max(top_k × 4, 60)条,默认就是 80 条。这是唯一的候选来源。 - 关键词打分。 用 BM25 算出原始分,再用 sigmoid 压到 0 到 1 之间。查询越长,sigmoid 的中点越高。
- 实体加分。 拿"阿里"去实体库搜索,给它链接的记忆加分:
相似度 × 0.5 × 热度惩罚。一个实体链接的记忆越多,惩罚越重。 - 过滤。 去掉已过期的,以及语义分低于 threshold 的。
- 融合排序。 每条候选的最终分是
(语义 + BM25 + 实体加分) / 满分,从高到低排。 - 可选重排。 只有传了
rerank=True才执行。 - 返回结果。 取前
top_k条。
算一遍分数
满分从 1.0 起步,这次查询有 BM25 结果就加 1.0,有实体加分再加 0.5。例子里三路都有,所以满分是 2.5。下表的分项是示意值,公式来自源码。
| 记忆 | 语义分 | BM25 | 实体加分 | 最终分 |
|---|---|---|---|---|
| 用户将入职阿里做后端 | 0.62 | 0.20 | 0.50 | 0.53 |
| 用户下个月搬去上海 | 0.35 | 0 | 0 | 0.14 |
| 用户住在北京 | 0.20 | 0 | 0 | 0.08 |
“阿里"那条的语义分只领先不到一倍,融合后却领先近四倍,功劳主要是实体命中的。
三个源码里才看得出的细节
- 关键词救不回语义排不进前 80 的记忆。 一条记忆即使关键词全中,只要语义上没入围,就不会出现在结果里。
- 分数不能跨查询比较。 满分随查询变化。同样语义分 0.8 的记忆,纯语义查询时最终分是 0.8,三路都有信号时可能只有 0.32。不要拿最终分设固定阈值。
- threshold 管的是原始语义分。 默认 0.1 很宽松,只过滤完全不相关的内容。
不过换个问法,比如"我在哪家公司上班”,查询里没有实体,实体这一路就不触发,排序就只能靠语义和关键词了。
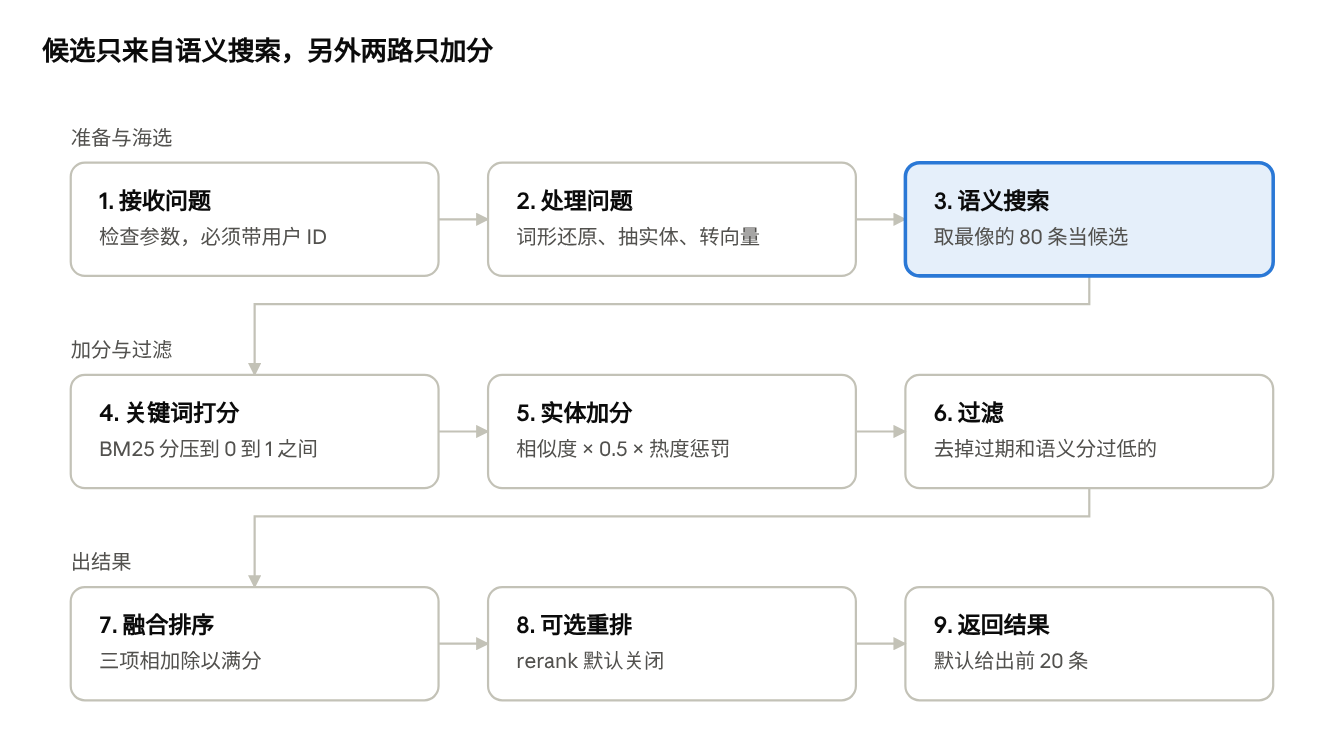
(图 3:检索记忆流程图)
新老版本对比:v3 砍掉了什么
v3 的思路说穿了就是做减法:少调一次大模型,少维护一个图数据库,换来更低的延迟和更简单的部署。
| 旧版 | v3(2026 年 4 月) | |
|---|---|---|
| 提炼 | 两次大模型调用:先抽事实,再决定增、改、删 | 一次调用,只新增 |
| 关系 | 可选外接图数据库 | 内置实体库,无需额外存储 |
| 检索 | 以语义搜索为主 | 语义 + BM25 + 实体加分 |
| rerank 默认值 | 开 | 关 |
官方发布说明称新的提炼流程延迟约为原来的一半(v2.0.0 发布说明)。顺便提醒一句,版本号有点绕:算法叫 v3,对应的是 Python SDK v2.0.0 和 Node SDK v3.0.0。
为什么只新增,官方的理由是,保留完整的状态变化历史,系统才能推理事情是怎么演变的,而不只是现在是什么(官方博客)。说白了,它把"判断哪条是最新的"这件事,从写入时推迟到了读取时。
我的评价:简洁的三个代价
简洁不是白来的。读完源码,我觉得这套设计有三个地方需要使用者自己兜底。
1. 新旧事实并存。 “住在北京"和"搬去上海"会同时留在库里,检索时也可能一起返回。哪条是现状,Mem0 不判断,要靠下游的大模型根据内容和时间戳分辨。记忆也只会越来越多,想清理只能自己调 update() 或 delete()。
2. 去重只认一字不差。 MD5 比对的范围只有最相似的 10 条旧记忆。“用户住上海"和"用户住在上海"哈希不同,拦不拦得住,完全取决于大模型在提炼时是否自觉避开。
3. 三个库之间没有事务。 实体链接这一步包在 try 里,失败只记日志,不中断写入。所以可能出现向量库有记忆、实体库却没有链接的情况。自己部署时,这里值得加监控或定期对账。
另外有一个隐性依赖:实体抽取和词形还原都靠 spaCy。不装 mem0ai[nlp],关键词和实体两路都会静默失效,检索退化成纯语义。中文场景下的实际效果,我自己还没来得及验证,这里不敢乱说。
总结:适合谁用
如果你的团队想要一个轻量、好部署的记忆层,Mem0 v3 挺合适:一个向量库加一个 SQLite 文件就能跑起来,每次写入的成本可预期。
如果你的场景需要严格的事实更新(比如地址变了就必须覆盖旧值),或者需要关系推理和时间推理,开源版就帮不上忙了。要么自己在外面补一层,要么考虑 Platform 版。
最后用一句话收个尾:一条记忆存成三份,写入时只让大模型做提炼这一件事,读取时用语义海选、另外两路加分。
参考资料
本文首发于 CSDN:Mem0 架构拆解:一条记忆是怎么被存下来、又被找回来的